[SpringBatch] spring batch 사용해서 대용량 처리
- Language/Spring
- 2026. 10. 13.
회사에서 dropbox의 특정 폴더의 모든 하위 파일을 가져와서 임베딩을 시켜야하는 작업이 필요했다. dropbox안에 얼마나 많은 파일이 있을지 몰라 서버에서 돌리기 너무 과부하였고 사용자가 임베딩을 요청하고 기다리게 하지 못했다.
그래서 spring batch를 사용하고 사용자가 요청시에 상태값을 이용해서 스케줄링 서버에서 임베딩을 시키도록 하였다.
플로우는 아래와 같다.
동기화요청 → task DB 저장 → 스케쥴러 서버에서 WAITING 상태 확인 → Spring Batch job 실행 -> 임베딩할 파일리스트 모두 db에 저장 -> 임베딩 -> task db 상태 완료로 업데이트
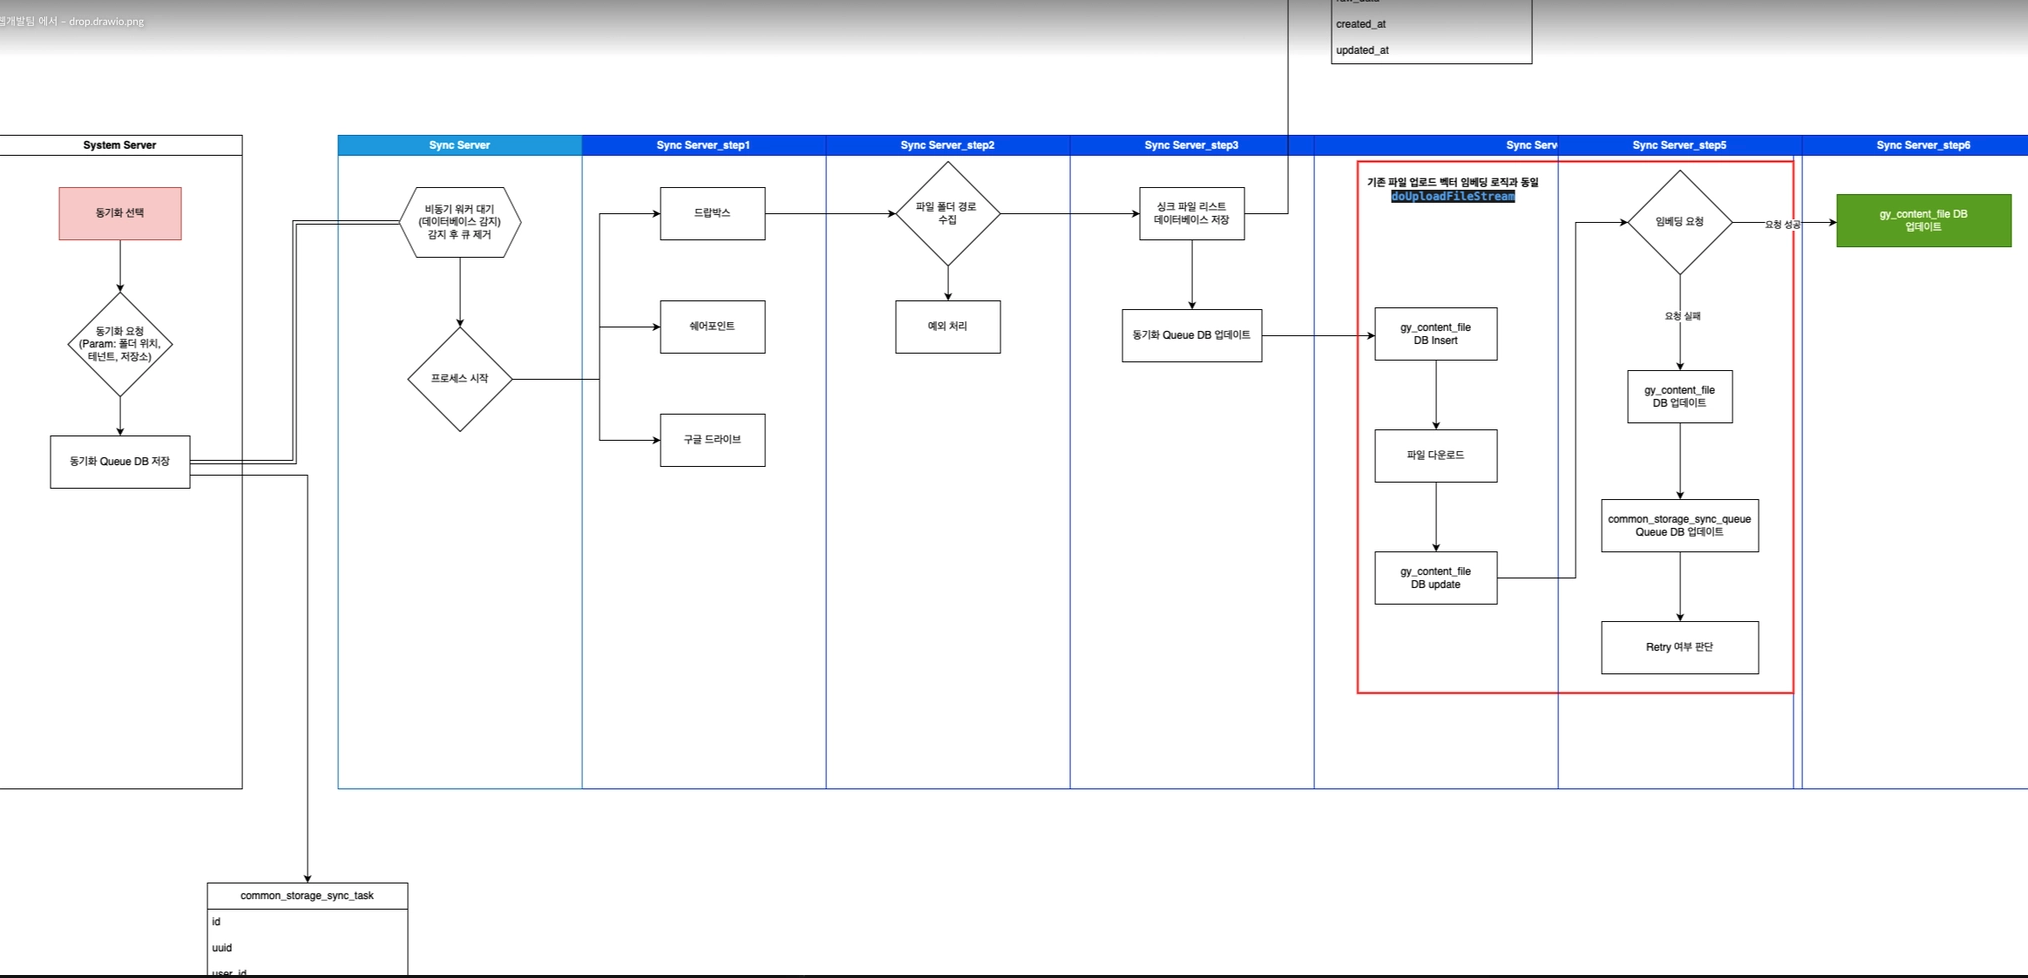
1. 임베딩 요청 -> task DB 저장
사용자가 특정 폴더를 임베딩 요청을 할시에 작업 대기 db에 저장을 하였다. STATUS 값을 WAITING으로 넣는다.
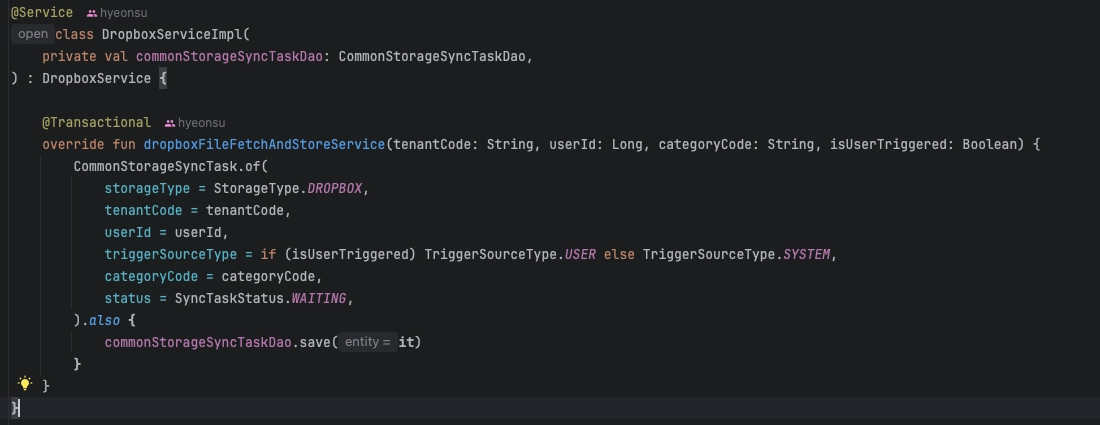
2. 스케줄러 서버에서 몇초마다 계속 돌면서 작업대기 db를 확인해서 WAITING 상태를 확인하고 job 등록
jobLauncher.run(embeddingJob, params) 코드로 job이 실행되며 파라미터를 추가하여 job을 실행 시킬수 있다.
요청되는 파라미터가 같은 job은 동일한 job으로 인식되므로 한번만 실행된다. startedAt 파라미터를 추가해서 매번 다른 job으로 인식되도록 했다.
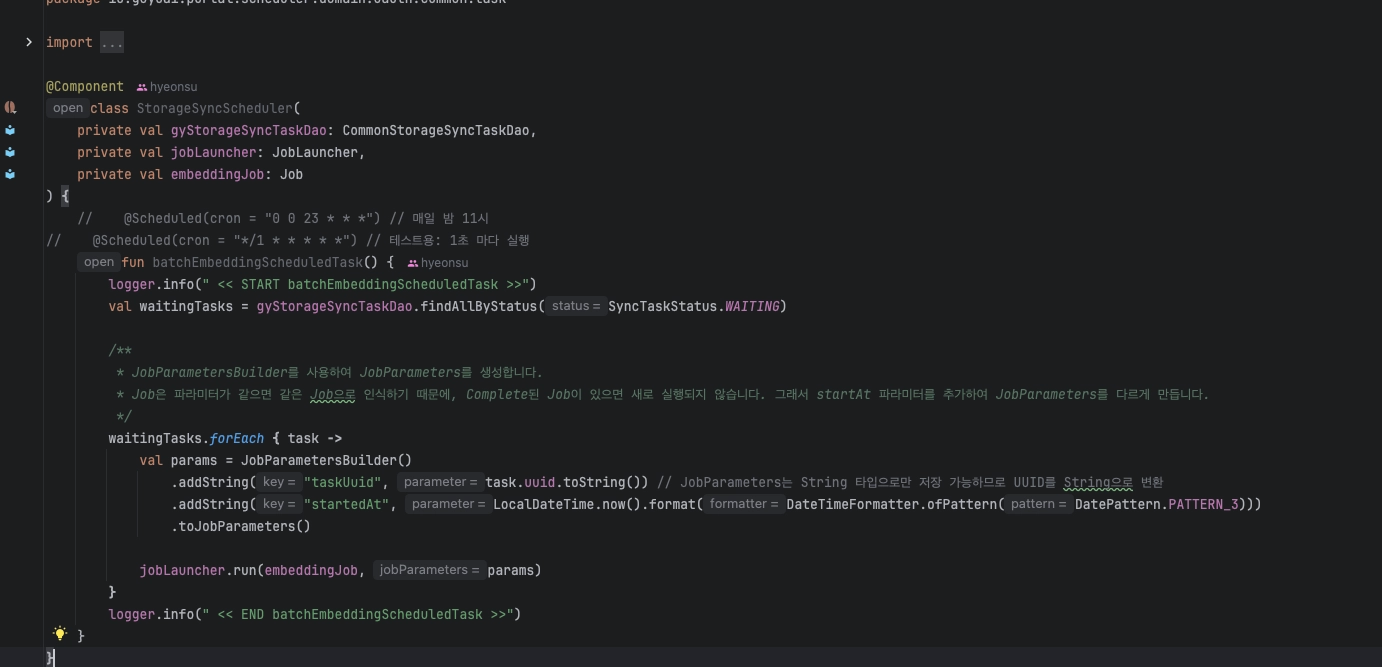
3. job 실행
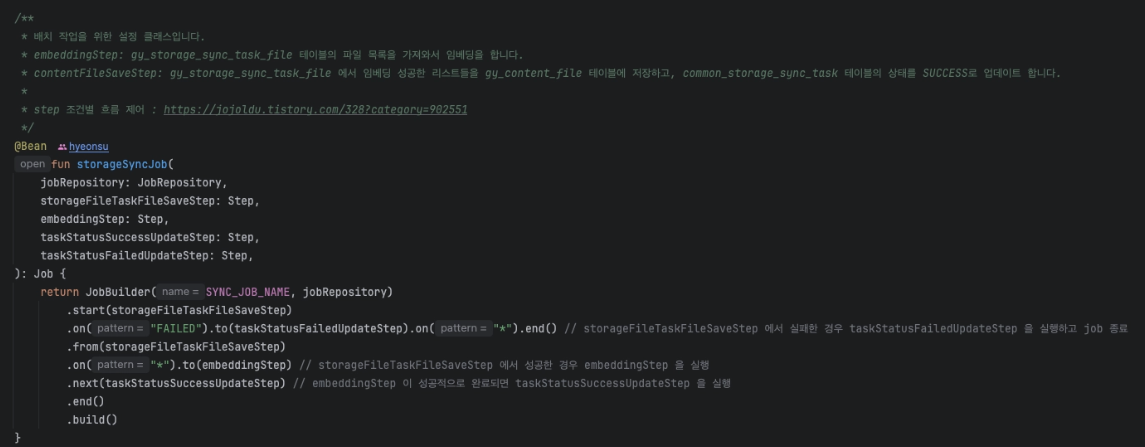
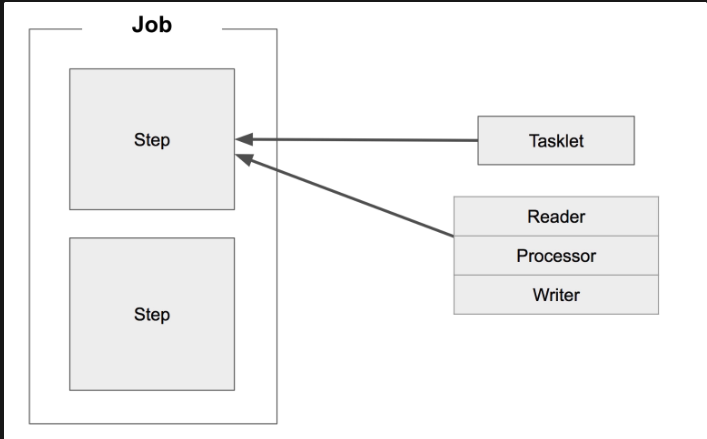
job의 구성
job은 기본적으로 step으로 구성된다.
step은 크게 2가지 종류가 있는데 tasklet으로 구성된 step과 reader, processor, writer 로 구성된 step이 있다
tasklet은 reader, processor, writer로 구분될 필요 없는 단순한 step을 만들때 사용된다.
reader, processor, writer로 구분된 step은 대량의 데이터를 chunk로 짤라서 부분 처리가 필요할때 사용되기도 하고 복잡한 작업을 나눌때 사용된다.
job에서의 step흐름은 on, from, to 를 통해서 step에 대한 성공 실패 분기 처리도 가능하다.
간단한 작업은 tasklet으로 간단하게 구현을 하면되지만 파일이 많을때 한번에 처리하는것보단 10개씩 일어서 처리한다던가하는 그런 작업이 필요했다. db에서 insert를 처리할때 몇만개 데이터를 한번에 넣지않고 100개 천개 끊어서 넣는 작업이라고 생각하면된다.
tasklet은 @JobScpoe로 구현하고, chunk는 @StepSoope로 구현한다.
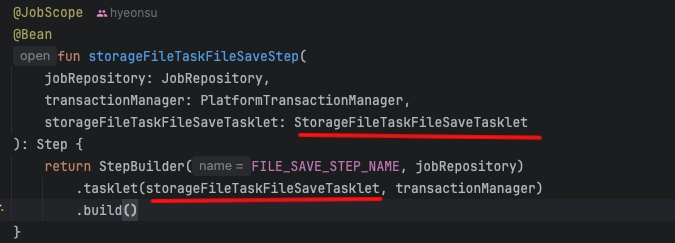

먼저 하는일은 dropbox에서 특정폴더의 하위 폴더 포함 모든 파일들을 조회해서 db에 저장한다.
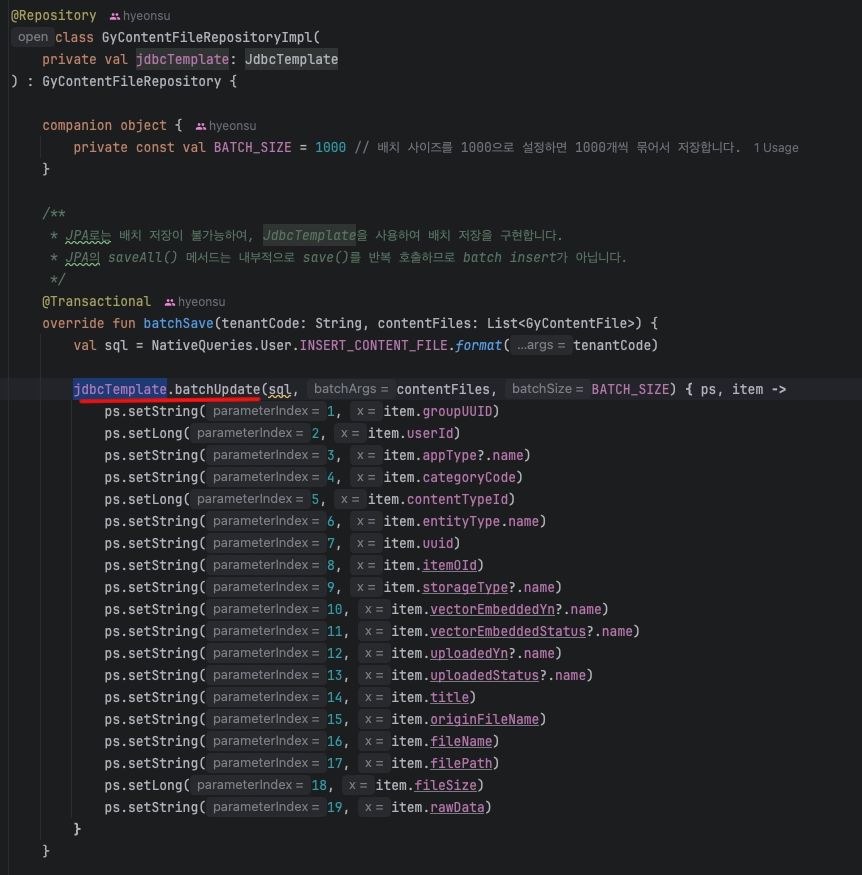
db저장할때 주의할점이 있는데 jpa를 사용해서 saveAllI() 이거는 batch 저장이 아니다. saveAll()은 한 트랜잭션안에서 save()가 여러번 도는것이다. 그래서 jdbcTemplate를 이용해서 batchUpdate()를 이용해야된다.
임베딩할 파일리스트를 저장하고나서 저기에 저장된 파일정보들 가지고 임베딩을 시키는데 이거를 chunk 방식으로하였다.
4. chunk 방식 임베딩
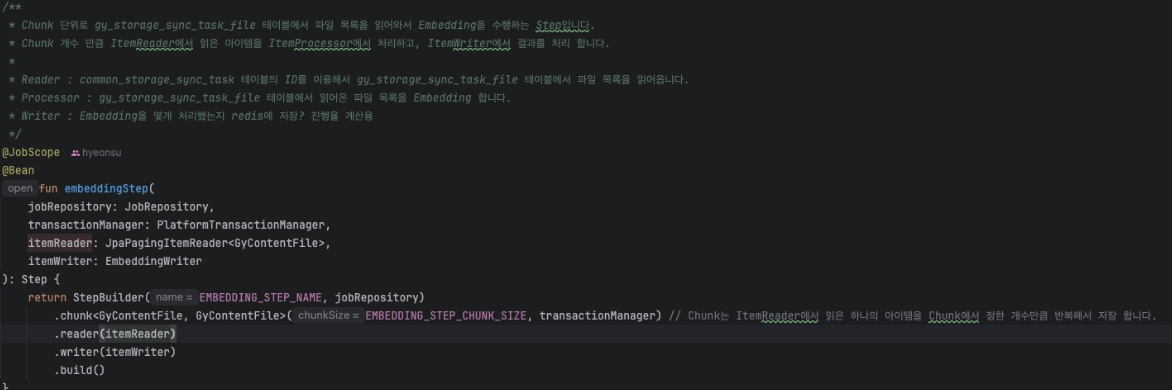
임베딩 step은 chunk 사이즈만큼 짤라서 reader, witer로 만들어졌다. processor는 필요없으면 생략가능하다.
chunk size 만큼 reader에서 읽은 다음에 데이터 하나하나에 대한 가공이 필요하면 processor가 필요하다.
reader 에서 읽은 chunk size 만큼의 파일을 writer에 전달해서 처리한다.
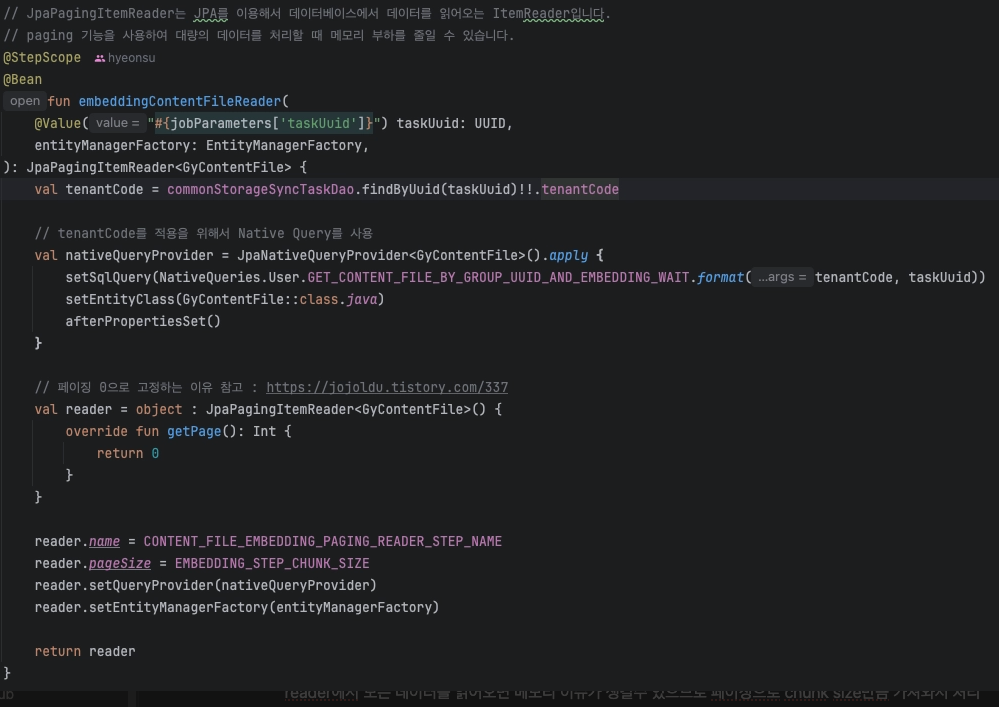
reader에서 모든 데이터를 읽어오면 메모리 이슈가 생길수 있으므로 페이징으로 chunk size만큼 가져와서 처리한다.
reader 구현은 여러가지 방식이 있지만 위에서는 jdbcPagingItemReader를 사용해 구현했다.
content_file에서 임베딩 상태가 WAITING인걸 paging 개수만큼 찾아서 writer에 전달하는 reader이다.
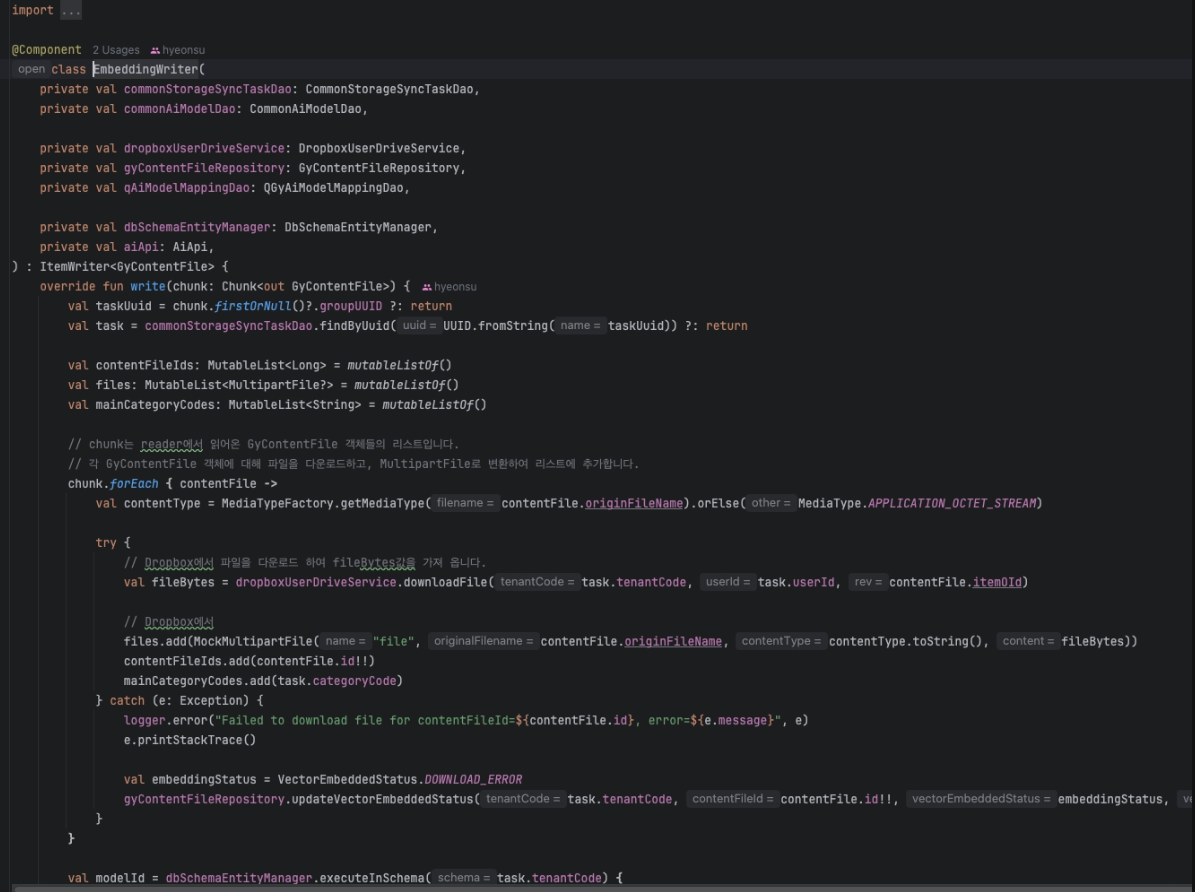
writer 에서는 reader에서 받은 content_file들을 묶어서 embedding 요청한다.
5. task 상태 완료 업데이트 step
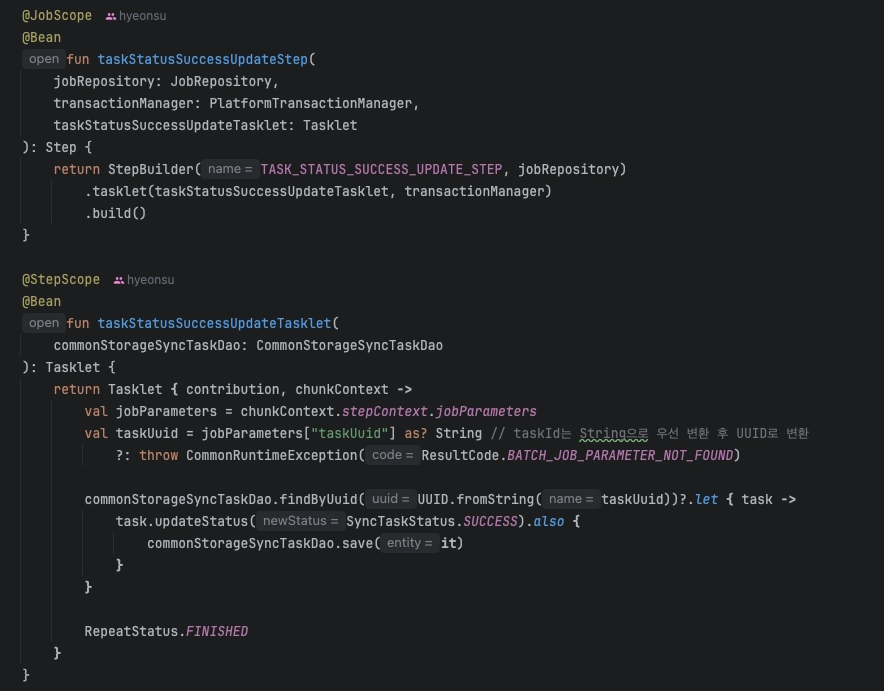
마지막으로 reader에서 읽을 파일이 더이상 존재하지 않으면(reader에서 null 반환) 다음 step으로 이동되고
task의 상태를 SUCCESS로 업데이트한다.
'Language > Spring' 카테고리의 다른 글
| [Spring] id 키값 타입Long을 UUID로 변경하기(H2 DB, JPA 사용) (0) | 2024.01.30 |
|---|---|
| [SpringBoot] 스프링 시큐리티 연동및 설정, 인메모리 방식 유저 추가 방법 (0) | 2021.12.18 |
| [SpringBoot] IntelliJ 에서 스프링부트 DevTools 사용법과 실행원리 (0) | 2021.12.01 |
| [SpringBoot] 기능구현한 코드를 코드로 테스트 하는방법및 주의사항 (0) | 2021.11.23 |
| [SpringBoot] 웹개발 3가지 방식과 동작원리 (2) | 2021.11.22 |